软硬件环境是
- ubuntu 18.04 64bit
- nvidia gtx 1070Ti
- cuda 11
- anaconda with python 3.7
视频看这里
Youtube
Bilibili
简介
2020年,来自印度海德拉巴大学和英国巴斯大学的团队,在 ACM MM2020 发表了的一篇论文 《A Lip Sync Expert Is All You Need for Speech to Lip Generation In The Wild 》,在文章中,他们提出一个叫做 Wav2Lip 的 AI 模型,只需要一段人物视频和一段目标语音,就能够让音频和视频合二为一,人物嘴型与音频完全匹配。
算法流程
Wav2Lip 的主要原理是将音频信号与面部图像进行联合训练,以实现从音频信号预测出与之匹配的唇形。
具体来说,Wav2Lip 的算法流程如下
首先,从音频中提取出相应的语音特征,例如 MFCC、Mel 频谱等。接着,将音频特征与面部图像进行联合训练,使用一种生成对抗网络(GAN)的结构,学习出一个从音频特征到唇形图像的映射。在生成唇形图像时,首先对输入的音频进行预处理,包括进行采样、滤波、预测等操作。然后,将预处理后的音频特征输入到已经训练好的生成器中,生成与之匹配的唇形图像。最后,将生成的唇形图像与原始视频进行融合,得到最终的结果。
快速体验
可以先到作者提供的体验站体验一番,地址是:https://bhaasha.iiit.ac.in/lipsync/example3/
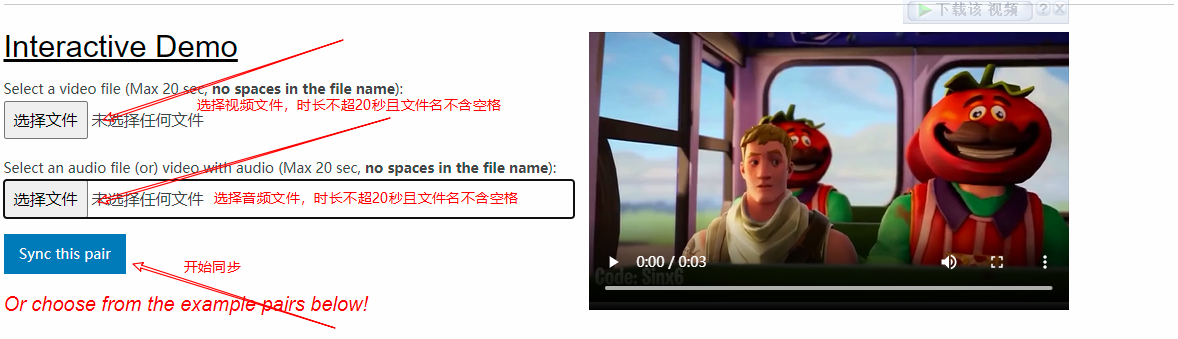
按照上图中的选择视频和音频上传即可同步。
实践
准备环境
首先使用 conda 创建新的虚拟环境,然后激活这个环境
conda create -n lip python=3.7
conda activate lip
接着来到官方网站,使用 git 克隆代码,或者直接下载源码压缩包解压,安装依赖
git clone https://github.com/Rudrabha/Wav2Lip.git
pip install -r requirements.txt
在 windows 平台上,使用了阿里云的 pip 源,发现找不到 torch 1.1 的版本,后来使用了最新稳定版1.7也没有问题,其它依赖库使用最新版也是 ok 的。
接下来需要安装 ffmpeg,这是音视频处理的神器,ubuntu 版本使用 apt 安装
sudo apt install ffmpegwindows 用户的话,可以到 https://github.com/BtbN/FFmpeg-Builds/releases 下载,解压后将 bin 对应的路径添加到系统环境变量 PATH 中。
准备素材
下面开始准备素材,我们把官方体验站上的测试视频下载下来,使用下面的命令
wget --no-check-certificate https://bhaasha.iiit.ac.in/lipsync/static/samples/game.mp4这个测试视频只有3秒,那接下来就去找个对应3秒的音频。如果能有现成的音频文件最好,如果没有的话,我的做法是这样的,从某个视频文件中提取音频,然后进行裁剪,这里需要的时长是三秒。这两步会使用到 ffmpeg 这个工具
# 视频裁剪,从第10秒开始,总时长是3秒,目标视频的音视频编码格式与原始的保持一致
ffmpeg -ss 00:00:10 -t 00:00:03 -i input.mp4 -vcodec copy -acodec copy test.mp4

# 从视频中提取音频
ffmpeg -i test.mp4 -vn test.mp3
准备模型文件
第一个需要的模型是脸部检测预训练模型,下载地址是: https://www.adrianbulat.com/downloads/python-fan/s3fd-619a316812.pth,下载后放到目录 face_detection/detection/sfd 中,并重命名为 s3fd.pth。脸部模型主要
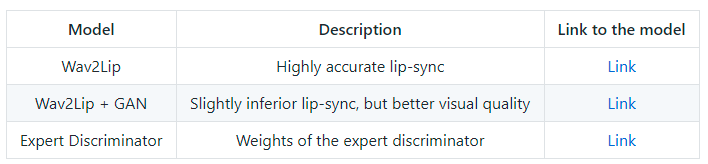
接下来去下载模型文件,这里作者提供了3个,可以任选一个,后两个优于第一个。它们的区别如下表所示,本文使用的是 Wav2Lip + GAN,下载地址:https://iiitaphyd-my.sharepoint.com/:u:/g/personal/radrabha_m_research_iiit_ac_in/EdjI7bZlgApMqsVoEUUXpLsBxqXbn5z8VTmoxp55YNDcIA?e=n9ljGW ,下载后放在项目根目录
运行代码
执行下面的命令将视频 test.mp4 和音频 3s.mp3 进行合成
python inference.py --checkpoint_path wav2lip_gan.pth --face test.mp4 --audio 3s.mp3最后,生成的新视频文件保存在 results/result_voice.mp4,生成的中间文件存放在 temp 下,像单独处理后的音频 temp.wav、视频 result.avi 等。
FAQ
ValueError: Face not detected! Ensure the video contains a face in all the frames.这个一般是由于片头或者片尾没有脸,解决方法也很简单,使用 ffmpeg 或者剪辑软件,将片头或片尾相应的帧剪掉就可以了
OpenCV(4.1.1) C:\projects\opencv-python\opencv\modules\videoio\src\cap_images.cpp:253: error: (-5:Bad argument) CAP_IMAGES: can't find starting number (in the name of file): C:\Users\gabri\Desktop\2019-11-22_13\a.avi in function 'cv::icvExtractPattern'.编辑 inference.py,将文件中的 temp/result.avi 改为 temp/result1.mp4,共2处
高清版本看这里
Youtube
Bilibili
下载地址
链接:https://pan.quark.cn/s/4a207febafeb